Prompt eingeben, warten, Enter. Prompt eingeben, warten, Enter. So sieht bei vielen Entwicklern inzwischen der Arbeitsalltag aus. Die KI schreibt den Code, der Mensch drückt auf Weiter. Das fühlt sich produktiv an, und in vielen Fällen ist es das auch.
Das Problem sieht man erst später. Nämlich dann, wenn der Pull Request beim Review landet.
TL;DR
KI-Slop ist Code, der schnell generiert, aber nie richtig geprüft wurde: ungelesene Diffs, unlesbar gekürzter Code, fehlende Tests und Kommentare.
Die beim Schreiben gesparte Zeit landet im Review, beim Senior mit dem wenigsten Kontext.
Tools allein lösen das nicht. Es braucht einen Anreiz, Verantwortung für KI-Code zu übernehmen.
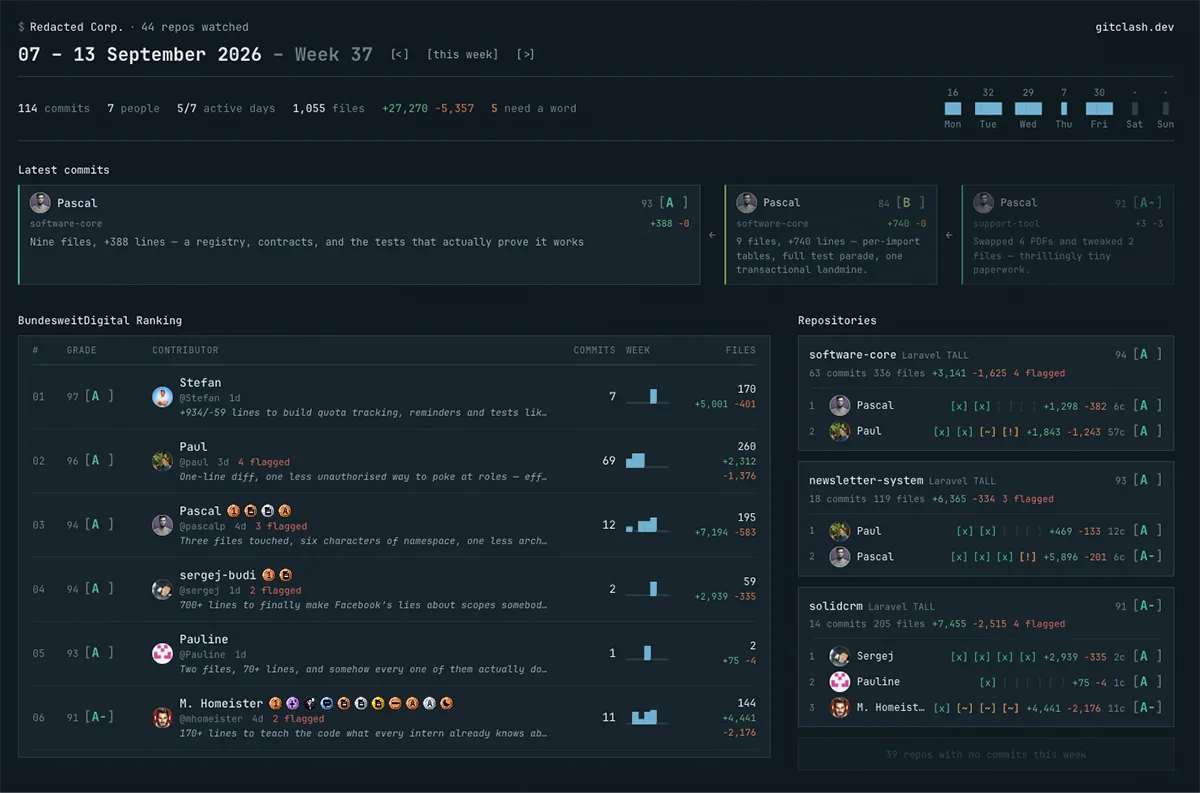
gitclash bewertet jeden Commit nach Qualität, Stack-Treue und Größe, mit Roast, Rangliste, Achievements und Shared Monitor fürs Büro.
Ergebnis im eigenen Team: kleinere Commits, gelesene Diffs, bessere Prompts, schnellere Reviews. Während der Beta ist gitclash kostenlos.
Was ist KI-Slop?
„Slop“ ist Englisch für Schweinefutter oder Pampe. Im KI-Kontext steht der Begriff für Inhalte, die schnell generiert, aber nie richtig geprüft wurden. Texte, Bilder, und eben auch Code.
KI-Slop im Code ist selten offensichtlich falsch. Er kompiliert, die Tests laufen durch (sofern es welche gibt), und das Feature funktioniert auf den ersten Blick. Aber niemand weiß so richtig, warum. Auch nicht die Person, die den Commit gemacht hat.
Als Senior-Entwickler arbeite ich täglich mit Junior-Entwicklern zusammen, die Bugfixes, neue Features und Funktionen mit KI umsetzen. Dabei sehe ich immer wieder dieselben Muster:
Der Diff wird nicht gelesen. Die KI ändert zwölf Dateien, geprüft werden zwei. Was in den anderen zehn passiert ist, fällt erst im Review auf. Oder gar nicht.
Code wird bis zur Unlesbarkeit gekürzt. Verschachtelte Ternaries, Einbuchstaben-Variablen, fünf Operationen in einer Zeile. Jede Abkürzung wird genommen, um Zeilen zu sparen.
Die Wartbarkeit bleibt auf der Strecke. Wer den Code in einem halben Jahr anfassen muss, braucht erst einmal eine halbe Stunde, um zu verstehen, was da überhaupt passiert oder prompted mit der nächsten KI einfach oben drauf.
Das Warum fehlt. Keine Kommentare an den kniffligen Stellen, keine aussagekräftige Commit-Message, keine Tests für die Randfälle, keine ADRs.
Ein Beispiel aus dem Alltag
So oder so ähnlich sieht Code aus, den ich regelmäßig im Review auf den Tisch bekomme:
$r = collect($o)->filter(fn($x) => $x->s && (!$x->d || $x->d > now()))
    ->map(fn($x) => [$x->id, $x->p * ($x->c ? (1 - $x->c / 100) : 1)])
    ->pluck(1, 0)->toArray();
Das funktioniert. Aber was ist s? Was ist d? Und was passiert, wenn c größer als 100 ist?
Dieselbe Logik, lesbar geschrieben:
$activeOffers = collect($offers)
    ->filter(fn (Offer $offer) => $offer->is_active && ! $offer->isExpired());

$pricesByOfferId = $activeOffers->mapWithKeys(fn (Offer $offer) => [
    $offer->id => $offer->priceAfterDiscount(),
]);
Ein paar Zeilen mehr, dafür versteht man den Code beim ersten Lesen. Und die Rabattberechnung steckt jetzt in einer eigenen Methode, in der man den Fall „Rabatt über 100 %“ abfangen und testen kann.
Weniger Zeilen sind kein Qualitätsmerkmal. Code wird einmal geschrieben und dutzende Male gelesen.
Das eigentliche Problem: der Review
Richtig unangenehm wird es, wenn ein Kollege zwei bis drei Tage an einem Feature arbeitet und der Pull Request dann bei mir landet. Mit 40 geänderten Dateien und ein paar tausend Zeilen Diff.
Jetzt soll ich in kürzester Zeit:
die Codeänderungen verstehen und prüfen,
Edge Cases testen,
im Blick haben, wo der Code unter Last oder mit ungewöhnlichen Daten scheitern könnte,
und dabei noch die eigene Arbeit erledigen.
Die Arbeit, die beim Schreiben gespart wurde, landet also nicht im Nirgendwo. Sie landet beim mir, dem Reviewer. Und ich habe weniger Kontext als die Person, die den Code geschrieben hat, weil ich zwei bis drei Tage Entstehungsgeschichte nicht miterlebt habe.
Ein gründlicher Review dauert dann Stunden. Ein oberflächlicher Review lässt Bugs in Produktion. Beides ist teuer.
Mit Tools allein ist es nicht getan
Die naheliegende Lösung wäre: noch ein Tool. Linter, statische Analyse, ein KI-Reviewer, der den KI-Code prüft. Das hilft alles ein Stück weit, aber es löst das Grundproblem nicht.
Das Grundproblem ist eine Haltung. Solange sich niemand verantwortlich fühlt für das, was die KI schreibt, wird der Code nicht besser. Es braucht einen Anreiz, sich beim Prompten, Kontrollieren und Nachpolieren mehr Mühe zu geben. Und dieser Anreiz sollte Spaß machen, statt sich nach Kontrolle anzufühlen.
Noch schlimmer wird es, wenn gar keine Entwicklern zum Zuge kommen sondern “Vibe-Coder” ganze Monolithen schreiben, ohne jemals den Stack bestimmt, Code-Qualität beurteilt oder die Datenstruktur gesehen zu haben. Da macht man es sich einfach: Wir geben es euch, ihr kontrolliert, ab zu production. Nun sollen komplette Apps in kürzester Zeit auf Funktionalität und Sicherheit geprüft werden. Die Verantwortung? Bei mir. Ich habe ja kontrolliert. Dabei wird nicht berücksichtigt, dass der verwendete Tech-Stack nicht meine Stärke ist oder wie ich 40k LOC sinnvoll reviewen soll.
Unsere Antwort: gitclash
Genau deshalb haben wir gitclash gebaut. gitclash bewertet jeden Commit einzeln und unabhängig, und zwar anhand des Stacks, der Codeänderungen, der Dokumentation, der Verbosität und der Tests. Bewertet wird dabei der Code, nicht die Person.
So wird bewertet
Jeder Commit bekommt eine Note, die sich aus drei Bereichen zusammensetzt:
Bereich | Gewichtung | Was geprüft wird |
|---|---|---|
Qualität | 55 % | Benennung, Struktur, Validierung, Autorisierung, N+1-Risiken, Testabdeckung |
Stack-Treue | 30 % | Nutzt der Code die Werkzeuge und Konventionen, die das Projekt ohnehin verwendet? |
Größe | 15 % | Wie viele Dateien und Zeilen ändert der Commit? Kleine, reviewbare Commits werden belohnt. |
Kriterien, die für einen Commit nicht zutreffen, werden nicht mit null bewertet, sondern herausgerechnet. Ein reiner Doku-Commit wird also nicht dafür bestraft, dass er keine Tests enthält.
Besonders wichtig ist uns die Stack-Erkennung. gitclash analysiert das Repository und bewertet nach den Konventionen des jeweiligen Frameworks. Unterstützt werden unter anderem Laravel, Next.js, Nuxt, SvelteKit, Astro, Django, FastAPI, Ruby on Rails, Go und Terraform. Wer in einem Laravel-Projekt eine eigene Validierungslogik zusammenbaut, obwohl es Form Requests gibt, merkt das an der Note.
Der Roast
Zu jedem Commit gibt es einen kurzen Roast. Ein augenzwinkernder Kommentar, der auf den Punkt bringt, was schiefgelaufen ist. Etwa so:
„Drei verschachtelte Ternaries in einer Zeile. Mutig. Dein zukünftiges Ich wird dir dafür eine Postkarte schreiben, und sie wird nicht freundlich sein.“
Der Roast soll nicht bloßstellen, sondern motivieren: Mach es beim nächsten Mal besser. Das funktioniert erstaunlich gut. Eine witzige, aber treffende Bemerkung bleibt deutlich länger hängen als ein nüchterner Hinweis im Code-Review.
Rangliste und Achievements
Alle Commits einer Organisation fließen in eine gemeinsame Rangliste ein, gewichtet nach der Anzahl der geänderten Dateien. Die Reputation gilt organisationsweit, wer zwischen Repositories wechselt, fängt also nicht wieder bei null an.
Dazu kommen 37 Achievements wie „Top of Leaderboard“, „Straight A“ oder „Se7en“ für sieben Tage am Stück. Sie landen dauerhaft im Profil und lassen sich auf LinkedIn teilen.
Der Shared Monitor fürs Büro
Unser Lieblingsfeature: Über einen Shared-Monitor-Link lässt sich die organisationsweite Rangliste auf den Fernseher im Büro spiegeln. Angezeigt werden Noten und Streaks, aber keine Commit-Messages, keine Code-Ausschnitte und keine Reviews. So gelangen keine sensiblen Daten auf einen Bildschirm, an dem auch Besucher vorbeilaufen.
Der Effekt im Team ist nicht zu unterschätzen. Plötzlich wird in der Kaffeeküche darüber diskutiert, warum ein Commit nur eine C-Note bekommen hat, und was man hätte anders machen können. Genau diese Gespräche wollen wir anstoßen.
Was sich im Alltag ändert
Seit wir gitclash im eigenen Team einsetzen, beobachten wir ein paar Dinge:
Commits werden kleiner. Wer weiß, dass riesige Commits schlechter bewertet werden, committet häufiger und in sinnvollen Schritten. Das macht den Review deutlich einfacher.
Der Diff wird wieder gelesen. Bevor committet wird, schauen die Entwickler selbst noch einmal drüber. Niemand will sich den Roast für einen vergessenen
dd()-Aufruf abholen.Die KI wird besser gepromptet. Statt „mach das Feature“ steht im Prompt plötzlich „nutze die bestehenden Form Requests und schreib Tests für die Randfälle“.
Reviews gehen schneller. Wenn der Code sauber benannt und gut strukturiert ist, kann sich der Reviewer auf die eigentliche Logik und die Edge Cases konzentrieren.
Tipps gegen KI-Slop, mit oder ohne gitclash
Jeden Diff lesen. Komplett. Wer eine Zeile nicht erklären kann, sollte sie nicht committen.
Lesbarkeit vor Kürze. Die KI ausdrücklich auffordern, sprechende Namen zu verwenden und auf Einzeiler-Akrobatik zu verzichten. Bei PHP z.B. nutzen wir Switch vor Match, auch wenn es mehr Code benötigt.
Die Projektkonventionen in den Prompt. Welche Patterns nutzt das Projekt? Welche Pakete sind bereits im Einsatz? Das gehört in den Kontext, zum Beispiel über eine
CLAUDE.mdoder eine ähnliche Projektdatei.Klein committen. Lieber zehn kleine, nachvollziehbare Commits als ein Monster-Commit nach drei Tagen.
Edge Cases selbst durchdenken. Was passiert bei leeren Listen, bei
null, bei doppelten Einträgen, bei fehlenden Berechtigungen? Und dann die KI Tests genau dafür schreiben lassen.Früh Feedback holen. Nicht erst nach drei Tagen den PR öffnen, sondern nach dem ersten Tag einen Draft-PR stellen.
Jetzt kostenlos ausprobieren
gitclash ist aktuell während der Beta kostenlos nutzbar. Keine Kreditkarte, keine Begrenzung der Nutzerzahl, keine Testphase, die heimlich ausläuft.
Die Einrichtung dauert wenige Minuten: GitHub-App installieren, Repositories auswählen, fertig. Die App bekommt nur Lesezugriff auf Inhalte und Metadaten und schreibt nie etwas in eure Repositories. Ab dann wird jeder neue Commit automatisch bewertet.
Unser Fazit
KI macht Entwickler schneller, keine Frage. Aber Geschwindigkeit beim Schreiben ist wertlos, wenn die gesparte Zeit im Review, beim Debugging und bei der Wartung doppelt wieder draufgeht.
Die Verantwortung für den Code liegt immer bei dem Menschen, der ihn committet, egal wer ihn geschrieben hat. gitclash macht diese Verantwortung sichtbar, und zwar auf eine Art, die mehr Spaß macht als der nächste Kommentar im Code-Review.
Quellen
Interesse? Dann schreib uns!
Wir helfen KMU dabei, KI und Automatisierung sinnvoll einzusetzen, ganz ohne Technikjargon.
Kostenlos anfragen →