Kaum ein KI-Launch hat 2026 so viel Aufmerksamkeit bekommen wie Jev. Das Modell von TypeSafe AI schreibt keinen einzigen Satz, es trifft Entscheidungen. Das Problem: Jev ist aktuell komplett ausgebucht, neue Anmeldungen sind nicht möglich.
Wir wollten nicht warten. Also haben wir uns die Alternativen angesehen. Der Platzhirsch unter ihnen ist klar: Laya AI.
Was Jev und Laya anders machen
Die meisten KI-Anwendungen im Unternehmen brauchen gar keinen Text. Ein Support-Ticket muss in die richtige Abteilung, eine Anfrage ist Spam oder nicht, eine Frage passt zu einem FAQ-Eintrag. Bisher wird dafür ein großes Sprachmodell verwendet, mit allem möglichem Kontext wie Handbücher und FAQs gefüttert, und daraus die passende Antwort für den User generiert. Make no mistakes. Das ist langsam, teuer und fehleranfällig.
Teuer vor allem deshalb, weil bei klassischen LLMs jedes ausgegebene Wort bezahlt wird. Die sogenannten Output-Tokens kosten bei den meisten Anbietern ein Vielfaches der Eingabe. Und Sprachmodelle antworten gern ausführlich: Statt „Rechnung“ kommt ein Absatz wie „Vielen Dank für Ihre Anfrage. Nach Analyse der Nachricht handelt es sich vermutlich um ein Anliegen zur Rechnung, da der Kunde …“. Jeder dieser Sätze kostet Geld und Zeit, obwohl am Ende nur ein einziges Wort gebraucht wird.
Jev und Laya sind sogenannte „System 1“-Modelle, und genau diesen Umweg sparen sie sich. Sie geben Werte aus, ohne sie in Sätze zu verpacken. Deshalb werden auch keine Output-Tokens berechnet.
Sie bekommen einen Text und eine Frage. Als Antwort gibt es genau drei Typen:
Noul: Ja oder nein als Wahrscheinlichkeit, etwa „Möchte der Kunde kündigen?“ → 0,89
Choice: eine Option aus einer festen Liste, etwa Rechnung, Technik oder Vertrieb
Score: ein Wert auf einer Skala, etwa Dringlichkeit von 1 bis 5
Jede Antwort kommt mit einer Wahrscheinlichkeit. Weil die Antworttypen fest definiert sind, lassen sie sich direkt maschinell weiterverarbeiten: Ein Choice-Wert steuert das Routing, ein Score landet als Zahl im CRM, ein Noul löst ab einem Schwellenwert eine Aktion aus. Niemand muss die Antwort erst aus einem Fließtext herauslesen, und weil nichts generiert wird, kann auch keine kaputte Antwort herauskommen.
Seit jeher versuchen Entwickler, die Ausgabe durch Prompts ins gewünschte Format zu bringen: “Gebe deine Antwort im folgenden JSON Format aus, ohne Codebox, Prefix und Suffix”.
Dazu kommt: System-1-Modelle sind keine Reasoning-Modelle. Sie denken nicht Schritt für Schritt nach und schreiben keine Gedankenketten, bevor sie antworten. Text, Frage und Antwortoptionen werden in Tokens zerlegt und in einem einzigen Rechendurchgang gemeinsam bewertet. Jede Option bekommt dabei eine Wahrscheinlichkeit, die bestpassende gewinnt. Genau deshalb ist das Ganze so schnell.
Das Ergebnis kommt als schlichtes JSON zurück. Für die Frage nach der zuständigen Abteilung sieht eine Antwort von Laya so aus:
{
  "type": "choice",
  "choice": "rechnung",
  "probabilities": { "rechnung": 0.94, "technik": 0.04, "sonstiges": 0.02 },
  "confidence": 0.91
}
Und in den Nutzungsdaten jeder Anfrage steht schwarz auf weiß: "output_tokens": 0.
Laya: offen, lokal, schnell
Laya stammt von Convai Innovations und steht unter der Apache-2.0-Lizenz. Die Gewichte liegen frei auf Hugging Face. Es gibt keine API-Gebühren und keine Warteliste, und die Daten verlassen nie den eigenen Rechner.
Das Modell ist so kompakt, dass es sogar auf einem MacBook mit M1-Prozessor läuft. In unserem Test lag die Antwortzeit dort im Schnitt bei 47 Millisekunden, die langsamste Anfrage brauchte 59 ms. Zum Vergleich: Jev als gehostete API braucht laut Hersteller etwa 150 ms, unabhängige Tests haben eher 245 ms gemessen.
Convai bietet drei vortrainierte Varianten an: das englische Grundmodell laya, laya-multilingual und laya-typed-decisions. Wir haben alle drei gegeneinander antreten lassen.
Unser Test: sechs Aufgaben aus dem Alltag
Ticket-Routing: In welche Abteilung gehört eine Support-Nachricht?
FAQ-Matching: Welcher FAQ-Eintrag beantwortet die Kundenfrage? Einmal mit der zusätzlichen Option „keiner passt“ (2), einmal ohne (2b).
Churn-Risiko: Deutet die Nachricht darauf hin, dass der Kunde abspringen will?
Dringlichkeit: Wie eilig ist das Anliegen?
Braucht einen Menschen: Lässt sich die Anfrage automatisch beantworten, oder muss ein Mitarbeiter ran?
Vornamen: Ist ein Vorname männlich oder weiblich?
Pro Aufgabe haben wir 10 bis 12 Fälle geprüft, bei den Vornamen 40.
Die drei Modelle im Vergleich
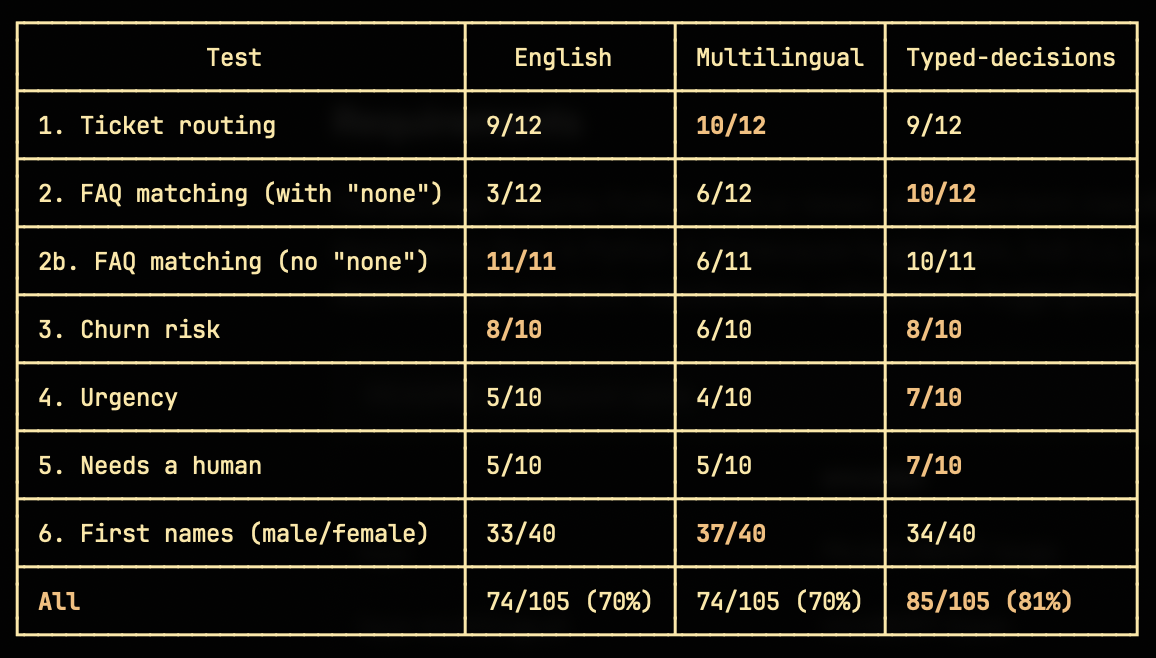
Typed-decisions gewinnt deutlich. Mit 81 % richtigen Antworten liegt es elf Prozentpunkte vor den beiden anderen Varianten. Und das ohne jedes Fine-Tuning, direkt so, wie der Entwickler es bereitstellt.
Was uns aufgefallen ist
Die Option „keiner passt“ ist der größte Stolperstein. Ohne sie ordnet das englische Grundmodell alle 11 FAQ-Fragen richtig zu. Sobald es zusätzlich „keiner passt“ wählen darf, sind es nur noch 3 von 12. Nur typed-decisions kommt damit zurecht (10/12). In der Praxis braucht man diese Option aber, denn nicht jede Kundenfrage steht im FAQ.
Einschätzungen sind am schwierigsten. Bei Dringlichkeit und der Frage, ob ein Mensch übernehmen muss, schafft selbst das beste Modell nur 7 von 10. Das sind die Aufgaben, bei denen auch Menschen oft unterschiedlicher Meinung sind.
Multilingual punktet bei Vornamen. Mit 37 von 40 ist es hier das beste Modell, vermutlich weil es mehr Namen aus verschiedenen Sprachen kennt. Bei den übrigen Aufgaben fällt es zurück.
Geschwindigkeit
Gemessen mit laya-typed-decisions auf dem MacBook M1:
Aufgabe | Richtig | Ø Antwortzeit | Langsamste |
|---|---|---|---|
1. Ticket-Routing | 9/12 | 50 ms | 55 ms |
2. FAQ-Matching | 10/12 | 49 ms | 55 ms |
2b. FAQ-Matching (ohne „keiner passt“) | 10/11 | 50 ms | 53 ms |
3. Churn-Risiko | 8/10 | 42 ms | 49 ms |
4. Dringlichkeit | 7/10 | 38 ms | 40 ms |
5. Braucht einen Menschen | 7/10 | 49 ms | 59 ms |
Gesamt | 51/65 (78 %) | 47 ms | 59 ms |
Keine einzige Anfrage hat länger als 60 ms gedauert. Das ist schnell genug, um jedes eingehende Ticket in Echtzeit zu sortieren, ohne Server und ohne API-Kosten.
Ein Hinweis zur Einordnung: Mit 10 bis 12 Fällen pro Aufgabe ist unser Test eine Stichprobe, kein Benchmark. Ein einzelner Fall macht hier schon 8 bis 10 Prozentpunkte aus. Die Tendenz ist aber eindeutig.
Wofür sich System-1-Modelle eignen
Überall, wo ein Text reinkommt und am Ende eine Entscheidung aus einer festen Auswahl stehen soll, ist ein System-1-Modell eine Überlegung wert. Ein paar Beispiele aus dem Alltag:
Use Case | Frage an das Modell | Typ |
|---|---|---|
Support-Tickets vorklassifizieren | Welche Abteilung ist zuständig: Rechnung, Technik, Vertrieb, Kündigung? | Choice |
E-Mails in Themenordner sortieren | Gehört die Mail zu Angebote, Rechnungen, Bewerbungen, Newsletter oder Sonstiges? | Choice |
Geschlecht eines Vornamens | Ist der Vorname eher männlich oder weiblich? Nützlich für die Anrede im CRM. | Choice |
Stimmung einer E-Mail oder eines Anrufs | Wie ist die Stimmung von verärgert bis begeistert? Bei Anrufen auf Basis des Transkripts. | Score |
Spam und Phishing erkennen | Versucht die Nachricht, Zugangsdaten oder Zahlungen zu erschleichen? | Noul |
Leads qualifizieren | Wie konkret ist die Kaufabsicht einer Kontaktanfrage, von „nur Info“ bis „will bestellen“? | Score |
Eingangsrechnungen vorkontieren | Welche Kostenart: Material, Software, Reisekosten, Miete, Sonstiges? | Choice |
Kundenbewertungen auswerten | Worum geht es in der Bewertung: Preis, Qualität, Lieferung oder Service? | Choice |
Sensible Daten erkennen | Enthält der Text Gesundheitsdaten, Bankverbindungen oder Ausweisnummern? | Noul |
Das Muster ist immer dasselbe: Das Modell sortiert vor, der Mensch kümmert sich um die Fälle, bei denen die Konfidenz niedrig ist. Mehrere dieser Fragen lassen sich in einem einzigen Aufruf stellen. Ein eingehendes Ticket bekommt so in einem Durchgang Abteilung, Stimmung und Dringlichkeit zugewiesen.
Direkt eingebaut in die eigene Software
Besonders stark sind System-1-Modelle als Baustein in Software, die ohnehin jeden Tag läuft: im CRM, in der Verwaltungssoftware oder am Telefon. Weil Laya lokal läuft, verlassen die Daten dabei nicht das Haus.
Software | Use Case | Frage an das Modell | Typ |
|---|---|---|---|
CRM | Dubletten finden | Beschreiben diese zwei Datensätze dieselbe Firma, auch wenn Schreibweise und Adresse abweichen? | Noul |
Zahlungsverkehr | Zahlungseingänge zuordnen | Zu welcher offenen Rechnung passt dieser Verwendungszweck? | Choice |
Telefonassistent | Anrufer weiterleiten | Worum geht es: Terminwunsch, Reklamation, Rückrufbitte oder Bestellung? In 50 ms, also noch während das Gespräch läuft. | Choice |
Kalender und Terminbuchung | Termin-Mails erkennen | Ist die Nachricht eine neue Terminanfrage, eine Verschiebung oder eine Absage? | Choice |
Dokumentenablage | Eingescannte Dokumente einordnen | Handelt es sich um Vertrag, Rechnung, Lieferschein, Mahnung oder Angebot? | Choice |
Genau solche Bausteine bauen wir bei BHP in individuelle Software ein: klein, schnell, ohne laufende API-Kosten und ohne dass Kundendaten an einen US-Anbieter gehen.
Worauf man achten sollte
Nur feste Antwortoptionen. Laya erklärt nichts und formuliert keine Texte. Die Kategorien müssen vorher feststehen. Bei mehr als etwa 20 Optionen wird es schwierig.
Auffang-Optionen testen. Eine Antwort wie „keiner passt“ oder „unklar“ ist sinnvoll, kann die Trefferquote aber drastisch senken. Das sollte man mit dem gewählten Modell ausprobieren.
Konfidenz ist nicht Genauigkeit. Ein hoher Wahrscheinlichkeitswert heißt nicht automatisch, dass die Antwort stimmt. Eigene Testdaten sind Pflicht.
Grenzfälle bei Namen. Wir haben nur zwischen männlich und weiblich unterschieden. Namen wie Kim oder Luca, die je nach Land unterschiedlich verwendet werden, bleiben ein Graubereich.
Sprachen. Für Deutsch gibt es eine mehrsprachige Variante. Bei Schriften außerhalb der Trainingsdaten liegt das Modell dagegen oft falsch, und zwar mit großer Überzeugung.
Unser Fazit
Wer auf Jev wartet, verpasst nichts, was sich nicht auch heute schon umsetzen lässt. Laya typed-decisions hat in unserem Test ohne jede Anpassung 81 % der Fälle richtig gelöst, in durchschnittlich 47 ms auf einem MacBook mit M1-Chip. Für Aufgaben wie Ticket-Routing, FAQ-Matching oder Datenbereinigung im CRM ist das eine ernsthafte Alternative, gerade wenn die Daten im Haus bleiben sollen.
Unsere Empfehlung: mit laya-typed-decisions starten, mit echten eigenen Daten testen und die Ergebnisse stichprobenartig prüfen. Etwa jede fünfte Antwort war in unserem Test falsch. Bei Einschätzungen wie Dringlichkeit sollte deshalb vorerst noch ein Mensch mitlesen.
Ein Risiko bleibt: Das KI Entscheidungen treffen ist nicht neu, Decision Modelle wie Laya AI und Jev machen dies nun noch einfacher doch wo ist der Human in the Loop? Sobald Modelle wie diese Bewerbungen automatisch ablehnen oder wichtige unternehmerische Entscheidungen getroffen werden, geht die Automatisierung zu weit. Der Mensch soll Mensch bleiben. Die Entscheidungen treffen noch wir.
Quellen
Interesse? Dann schreib uns!
Wir helfen KMU dabei, KI und Automatisierung sinnvoll einzusetzen, ganz ohne Technikjargon.
Kostenlos anfragen →